方法与工具 / PRACTICE NOTE
知识库不是资料堆:让业务 Agent 答得准的三层整理法
把公司文档一股脑塞给 Agent,答不准多半不是模型的错。本文拆解三层整理法:先清存量、再切块补上下文、最后把真实问题沉淀成问答资产,让检索先找对,再谈答得好。
摘要
业务 Agent 答不准的常见根因在知识库不在模型:文档未经清理直接入库,检索会先找错。三层整理法——存量清理(去重、过期下线、口径统一)、切块加工(按语义切分并为每块补出处等上下文)、问答沉淀(高频真实问题沉淀为标准问答、bad case 每周回流)——系统性抬高回答准确率的上限。
- 体裁
- 实践文章
- 适用对象
- 正在为业务团队搭建知识库问答 Agent 的负责人和实施人员
- 参考来源
- 3 项 · 详见文末
答案先行
业务 Agent 答不准,先别急着换模型——多数时候是检索先找错了资料,生成再强,也只能把错的内容说得像真的。知识库要先整理再入库:清存量、切好块、沉淀问答,三层做完,回答准确率才有地基。
第一层:存量清理——过期的、重复的、自相矛盾的先清掉
检索增强生成(RAG)的基本原理是先检索、再生成:模型能看到什么资料,答案的上限就是什么。企业知识库最常见的脏法有三种:同一份制度三个版本同时在线;已经作废的流程还留在库里;同一件事在不同文档里口径不一致。Agent 检索到哪一版,就按哪一版回答,错得理直气壮。
做法不复杂,但要有人负责:给每份文档建台账,写清责任人、生效日期、版本;过期文档下线,重复文档合并,口径冲突时以最新正式版为准并标注来源。存量不清,后面两层做得再细也是在脏数据上加工。
第二层:切块加工——别把整本手册切成谁也读不懂的碎片
文档入库前要切块,检索命中的是块,不是整篇。整篇灌入会稀释重点,机械地按固定字数切,又会把"操作步骤"和它的"前提条件"拆到两个块里,检索到哪一半都答不完整。
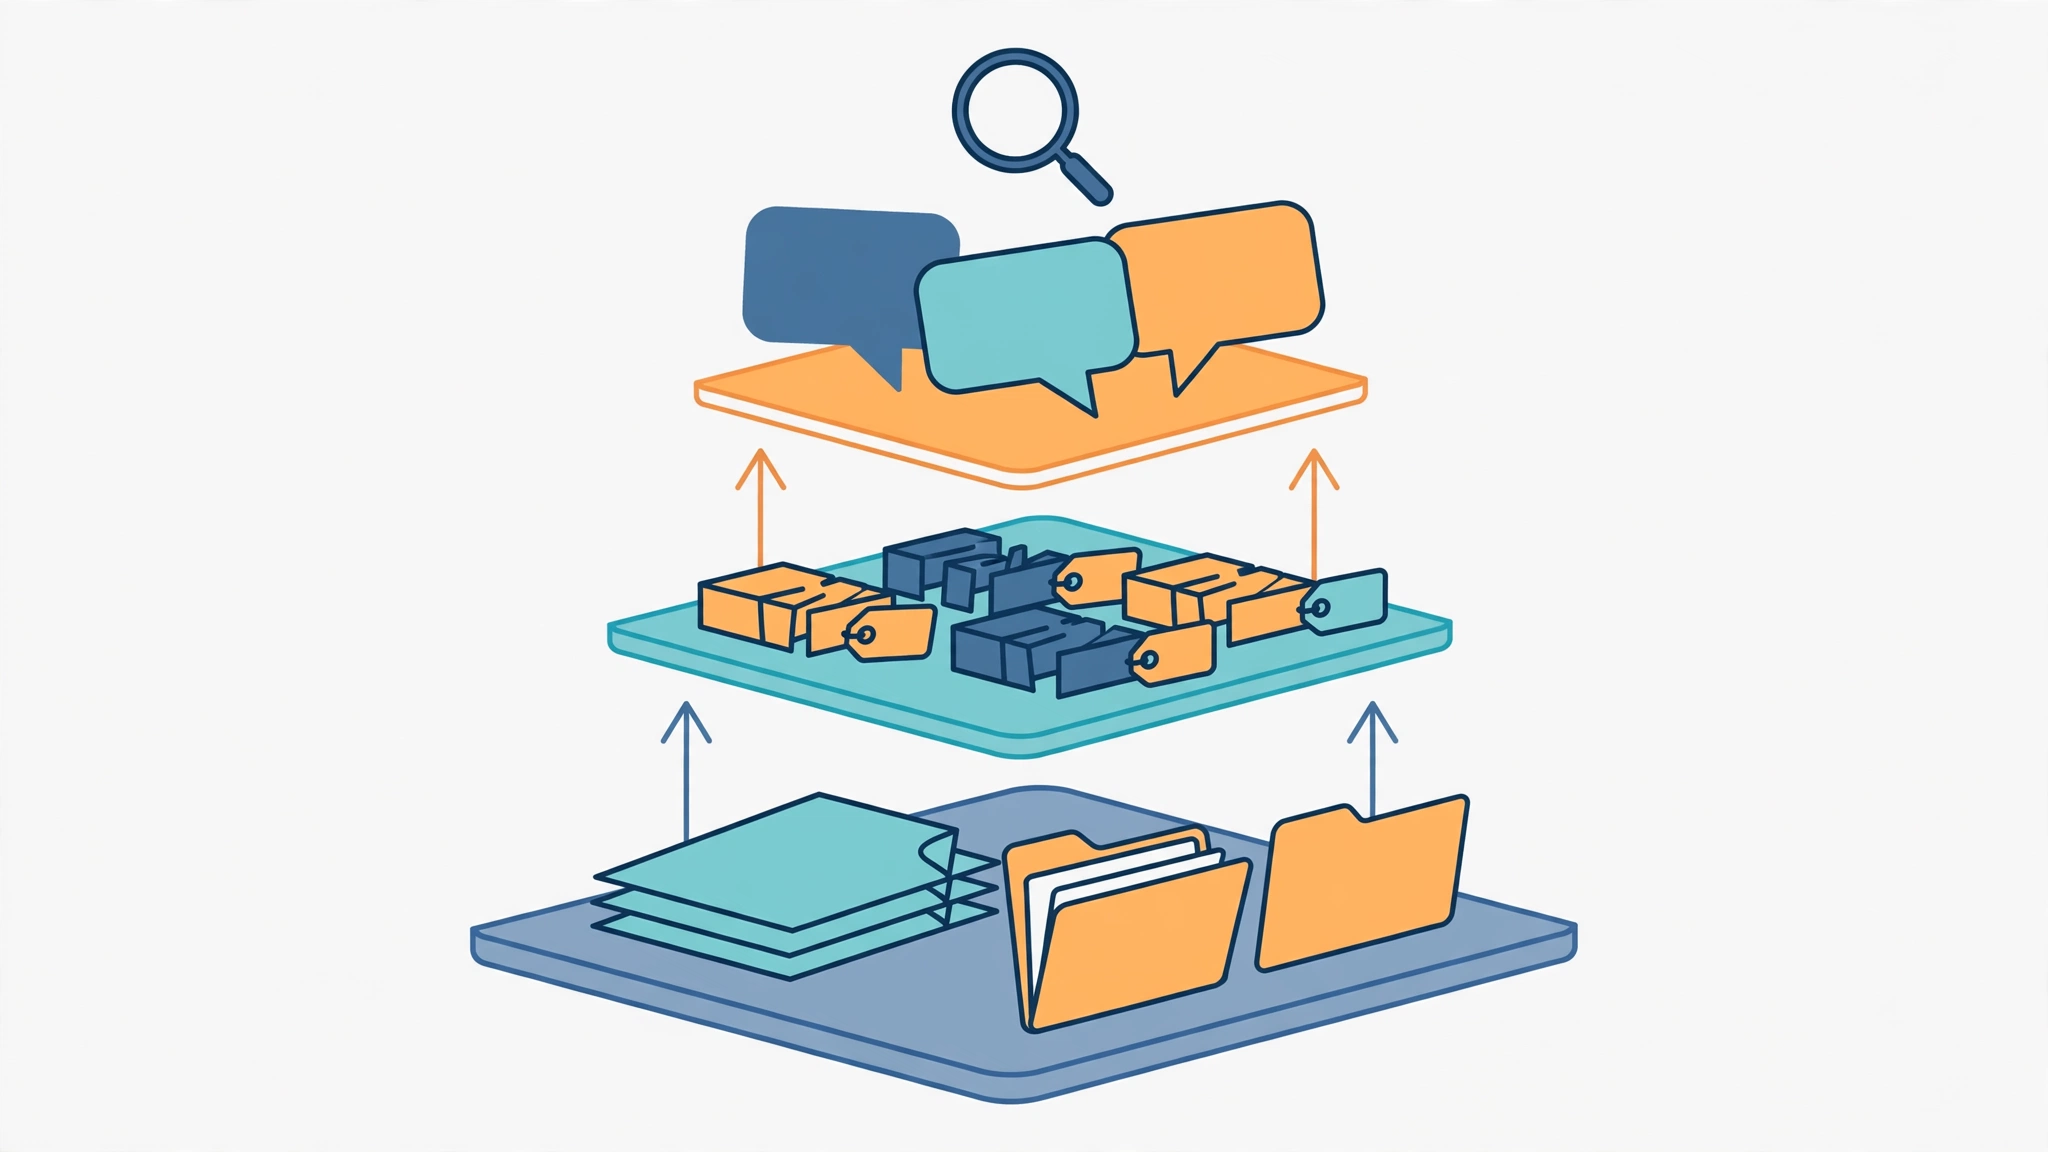
Anthropic 在 Contextual Retrieval 里给了一个可直接借鉴的做法:为每个切块先生成一句上下文说明——这块出自哪份文档、解决什么问题、适用于谁——再连同原文一起索引,官方实验中检索失败率明显下降。落到日常操作就是三件事:按语义边界切(一个步骤、一个条款、一个问答各成一块);每块补齐出处、适用对象、生效时间;表格和清单保持完整,不拆散。
第三层:问答沉淀——把真实问题变成资产
上线之后的真实提问是金矿。用户问了什么、Agent 答了什么、哪里答错或答不上来,每周回流一次:高频问题沉淀成标准问答(问题、标准答复、出处),检索时优先命中;答错的案例回到前两层找原因,是资料过期还是切块丢了上下文。
还有一条底线:每个答案尽量标出处;资料里没有的,明确说不知道并转人工。让 Agent 承认答不上来,比编一个像样的答案安全得多。
上线前自检清单
- 抽 30 个真实业务问题盲测,看命中的资料对不对、答案引用的版本新不新
- 随机抽查 10 份文档,确认没有过期版本还挂在库里
- 随机抽 10 个切块,确认出处、适用对象、生效时间都在
- bad case 有没有固定的回流节奏,谁负责、多久一次
三层整理不新鲜,难的是把它变成日常动作:新文档入库先过第一层,制度变更同步更新台账,问答沉淀每周雷打不动。知识库的质量上限,就是 Agent 回答的质量上限。
参考来源
常见问题
知识库不大,也要做三层吗?
层数不变,动作变轻:几十份文档时,存量清理就是一张台账表,切块加工人工过一遍即可,问答沉淀从客服高频问题开始攒。
换更强的模型,答不准会好吗?
更强的生成只会把检索到的内容说得更顺;检索找错时,反而更像真的。先修检索和资料,再考虑换模型。
多久整理一次?
存量随制度变更即时更新;问答沉淀建议每周回流一次;每季度做一次全量抽检,重点看过期文档和口径冲突。